Trucos de productividad en Hermes: delegación, memoria y cron
Hay una diferencia enorme entre usar Hermes como un chat y usarlo como una herramienta de trabajo, y la diferencia no está en el modelo ni en la memoria: está en cuánto trabajo le delegas de verdad y en qué lo gastas. Un agente al que le pides “revisa esto y dime qué ves” te da una respuesta. Un agente al que le pides “revisa esto, aplica el arreglo y avísame cuando esté” te da un resultado. La diferencia entre las dos cosas no está en el prompt: está en si el agente tiene herramientas, en si puede trabajar en segundo plano y en si tiene permiso para actuar sin preguntarte en cada paso.
Este post es el catálogo de lo que he aprendido a hacer distinto después de un tiempo usándolo a diario. No son trucos cosméticos: son los ajustes y los patrones que evitan que una sesión desperdice su presupuesto en mitad de la tarea y que leave al agente parado esperando una confirmación que nadie va a ver. El más importante de todos lo he puesto primero, porque es el que más dinero cuesta cuando está mal.
TL;DR — Lo que vas a tener al final
- Tiempo de setup: 30 minutos de lectura y dos capturas con el patrón de cron sin agente y los dos niveles de memoria
- Requisitos: tener Hermes con al menos un trabajo programado y haber-Lo usado en modo chat un par de semanas
- Resultado: diez patrones concretos: cómo gastar cero tokens en un cron, cómo recuperar contexto perdido, cómo recuperar una sesión que se comió el presupuesto y cómo evitar el bucle de Confirmaciones
- Troubleshooting: si un trabajo programado falla con un error de proveedor, el mensaje que ves casi nunca es la causa real; el archivo de salida del cron sí lo es
1. El cron sin agente: el truco que más dinero ahorra
Hermes tiene dos tipos de trabajo programado y la diferencia en costo es de dos órdenes de magnitud. El primero invoca al modelo: escribe un prompt, el cron lo ejecuta, el modelo produce una respuesta y esa respuesta es la que te llega. El segundo ejecuta un script y entrega su salida tal cual, sin pasar por el modelo en ningún momento.
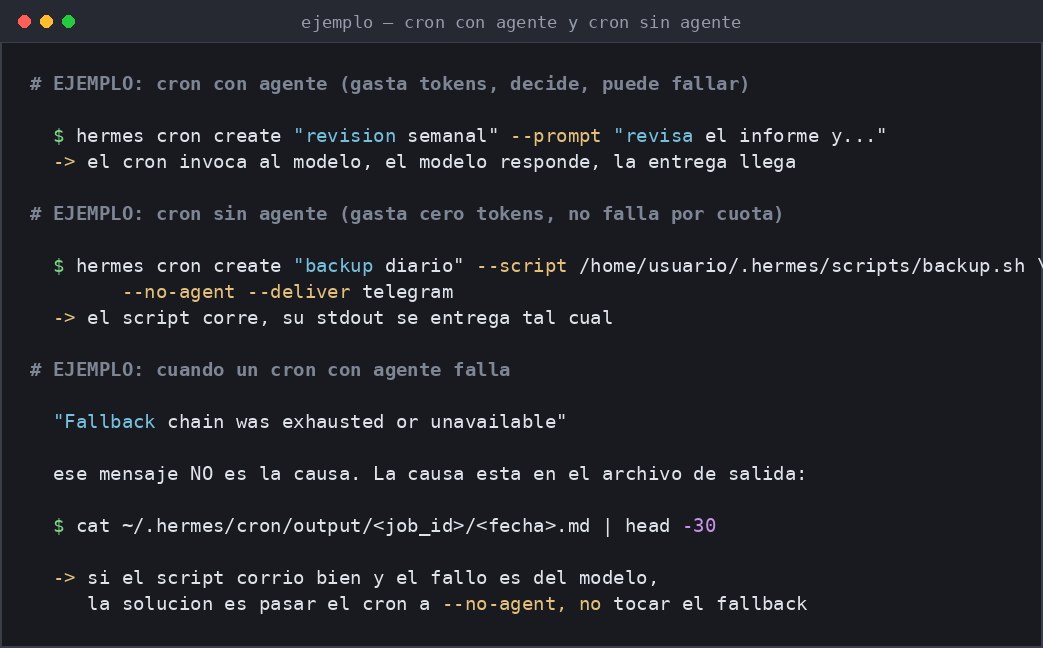
La regla es simple: si un script puede hacer el trabajo, el cron no debería usar el modelo. Un reporte que se arma con un script de shell, una consulta que devuelve una tabla, un backup que verifica y manda el resultado: todo eso es un cron sin agente. El modelo solo entra cuando el trabajo requiere interpretar, decidir o redactar.
# EJEMPLO: trabajo programado que no consume tokens
hermes cron create "backup diario"
  --script /home/usuario/.hermes/scripts/backup.sh
  --no-agent --deliver telegram
# EJEMPLO: la salida de un cron sin agente llega como el stdout del script
cat ~/.hermes/cron/output/<job_id>/<fecha>.md
Y de ahí sale el segundo truco, que es el que más tiempo me ha ahorrado: cuando un trabajo programado falla, el mensaje que te llega no es la causa. Un error como “cadena de proveedores agotada o no disponible” no dice qué pasó: dice que el modelo no respondió. La causa real está en el archivo de salida de ese trabajo en esa fecha, y hay que leerlo primero. Si el script se ejecutó bien y el fallo fue del modelo, la solución no es tocar la configuración de proveedores sino pasar ese trabajo al modo sin agente.
2. Ponle topes a la delegación antes de que la necesites
Hermes puede lanzar subagentes, y esa capacidad es BINARIA: o la usas con límites puestos, o la usas sin ponerlos y un día te cuesta una fortuna.
El problema concreto es la profundidad. Los límites relevantes viven en la sección delegation de la configuración y son tres: max_iterations acota las vueltas de un agente, max_concurrent_children acota los subagentes simultáneos y max_spawn_depth acota los niveles de anidamiento.
Y aquí está el truco que no está en la documentación: el límite de profundidad no siempre frena el anidamiento. Si hay dos puntos distintos del código que cuentan la profundidad de forma diferente, uno con una comparación y otro con un conteo de prefijos, el conteo se puede reiniciar al reconstruir la sesión padre y el anidamiento se cuela. El límite entonces parece puesto y no lo está.
La defensa práctica tiene tres partes. La primera, poner max_spawn_depth en uno, que es el valor que de verdad corta la explosión. La segunda, limitar max_concurrent_children a dos o tres. Y la tercera, que es la que más se subestima: vigilar el consumo real en vez de confiar en que el tope se respeta.
3. Nunca delegues la revisión de contenido a subagentes
Esta es una regla que me costó una sesión entera de trabajo y cinco horas. Una revisión de contenido delegada a nueve subagentes en un árbol de cuatro niveles consumió 6,52 millones de tokens, seis de los nueve hijos murieron por compresión de contexto y el resto chocó con el error de límite del plan. Y lo peor no fue el costo: fue que no revisó ningún post. Toda la producción para nada.
La razón es fácil de entender una vez que la ves. Cada subagente arrastra el contexto de la conversación del padre, más el contexto que le pasas, más su propio historial. En un árbol de cuatro niveles, el contexto se multiplica. Y cuando un hijo muere por compresión, el padre no reintenta bien: se queda con la mitad de la información y produce una revisión peor que no hacer nada.
La regla que aplico desde entonces: la revisión y el fact-check se hacen en el hilo principal, nunca delegados. Delegar tiene sentido para trabajo mecánico y paralelo, como buscar cinco archivos o aplicar el mismo cambio a seis sitios. Delegar una tarea que requiere juicio sobre calidad es exactamente el caso donde el contexto compartido importa más que el paralelismo.
4. Dos niveles de memoria, y no es uno
Hermes tiene memoria de dos clases y confundirlas es la causa número uno de que el agente “olvide” cosas o se repita.
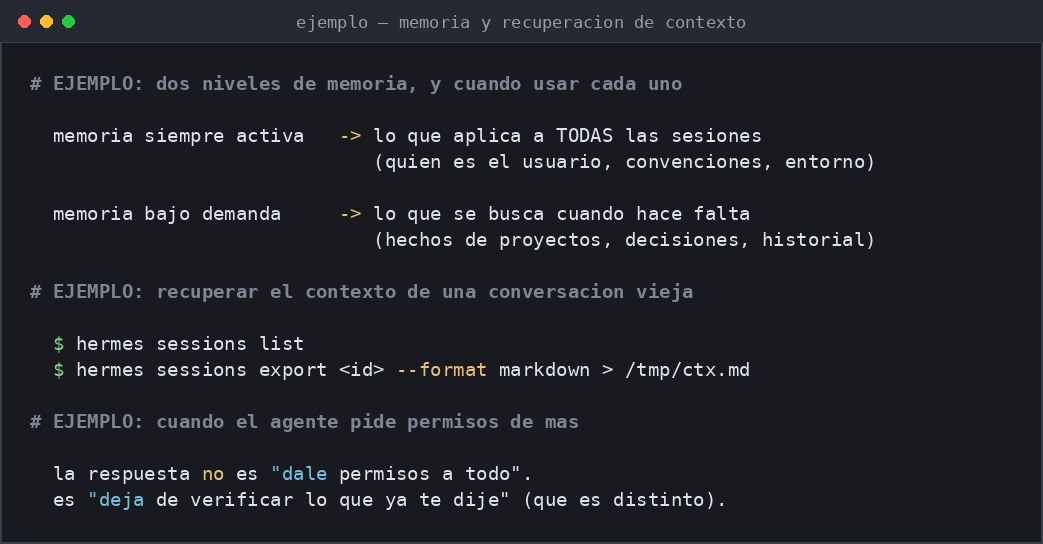
La memoria siempre activa es un conjunto corto de hechos que se inyecta en cada turno: quién eres, qué convenciones manejas, cómo es tu entorno. Es lo que evita tener que explicar cada vez. Y su límite es real: es un presupuesto de caracteres, así que si la llenas de cosas que solo aplican a un proyecto, la estás desperdiciando en todos los demás.
La memoria bajo demanda es un almacén consultable: hechos de un proyecto, decisiones tomadas, historial. No se inyecta, se busca. Y hay un criterio de partición que me funciona bien: a la memoria siempre activa va lo que aplica a todas las sesiones, y a la bajo demanda va lo que es de un proyecto concreto. Un hecho que es de un solo cliente no pertenece en la primera.
5. Recuperar una sesión es más fácil de lo que parece
Cuando una sesión se corta a la mitad o el contexto se comprime, la información no está perdida: está en la base de datos de sesiones, y se puede exportar.
# EJEMPLO: ver las sesiones recientes
hermes sessions list
# EJEMPLO: exportar una sesion como markdown para leerla o buscarla
hermes sessions export <id> --format markdown > /tmp/contexto.md
# EJEMPLO: limpiar lo viejo
hermes sessions prune --older-than 30
Y hay un caso donde la exportación es directamente la solución: cuando el agente tomó una decisión que no te cuadra y quieres ver exactamente qué hizo. El historial exportado te muestra el razonamiento, las herramientas que llamó y los resultados, que es la única forma de depurar una sesión mala en vez de adivinar.
6. Cuando el agente pide demasiados permisos
El patrón que más molesta es el agente preguntando cosas que ya están resueltas: “¿puedo leer este archivo?”, “¿puedo ejecutar este comando?” que es exactamente lo que le dijiste que hiciera hace tres mensajes.
La respuesta correcta no es darle permisos globales, que es abrir la caja de Pandora. Es corregir la fuente de la pregunta. Y hay dos motivos distintos por los que vuelve a preguntar. El primero, no tiene el dato en el contexto y le falta cargarlo de la memoria o de una skill. El segundo, el ajuste de aprobación está en manual y cualquier comando con patrón peligroso pregunta siempre. En el primer caso se arregla guardando el hecho; en el segundo, se arregla con la lista blanca de comandos y con un modo de aprobación que no esté preguntando por todo.
7. Ejecuta en un solo paso lo que son muchas llamadas
Un detalle de la interfaz que cambia el rendimiento más de lo que parece: cuando una tarea implica tres o más llamadas a herramientas con lógica entre ellas, ejecutarlas de forma programática en una sola pasada evita que cada resultado vuelva al contexto del modelo y se multiplique el costo. La versión de código tiene acceso a las mismas herramientas y te deja filtrar y reducir antes de que la información entre.
Esto no es un detalle menor. La diferencia entre “leer veinte archivos y buscar uno” ejecutado con veinte llamadas al modelo y ejecutado con una búsqueda que devuelve el resultado filtrado es de un orden de magnitud en tokens.
8. Background para lo largo, no para todo
Las tareas en segundo plano son lo correcto cuando el trabajo tarda más que tu paciencia, y son un desperdicio cuando el trabajo es de treinta segundos. El criterio es simple: si el resultado te interesa cuando termine y no mientras tanto, va en segundo plano. Si necesitas verlo para decidir el siguiente paso, va en primer plano.
Y hay un detalle de las notificaciones que conviene aprovechar: se pueden configurar para avisar cuando el proceso termina o cuando una línea coincide con un patrón. La segunda es la útil para procesos largos: no quieres que te avise de cada línea, quieres que te avise cuando aparezca el error.
9. Los perfiles separan contextos que no se deben mezclar
Si trabajas con clientes distintos o con proyectos que tienen credenciales distintas, un solo perfil es un problema de seguridad esperando. Cada perfil tiene sus propias skills, plugins, trabajos programados y memorias, y su propio directorio de configuración.
El patrón que funciona es simple: un perfil por cliente o por entorno, y el agente no ve nada del otro. No es una organisationcomplexa: es no meter las credenciales de un cliente en el directorio del otro.
10. El tablero para el trabajo de varios pasos
Cuando una tarea tiene más de tres pasos que dependen entre sí, el chat se queda corto: pierdes de vista qué falta, en qué punto estás y qué quedó bloqueado. El tablero de Hermes existe para eso, y tiene una virtud que importa más de lo que parece: el trabajo queda en disco. Si se corta la sesión, el contexto de la tarea sobrevive.
Y tiene una segunda virtud, la que más me costó aprender: la tarea se puede despachar en paralelo con un límite explícito de concurrencia. Eso convierte una lista de diez tareas en un proceso que avanza solo, con un tope que decides tú en lugar de descubrirlo cuando la factura llega.
Preguntas frecuentes
¿Cuándo conviene un trabajo programado con agente y cuándo sin agente?
Cuando la tarea es un script que ya se puede ejecutar, sin agente. Si el trabajo necesita que alguien interprete el resultado, redacte un resumen o decida qué hacer según lo que pase, entonces con agente. El caso intermedio, un script que genera un informe y el modelo que lo resume, es el peor de los dos mundos: paga el modelo por un texto que el script podía formatear.
¿Por qué mi trabajo programado falla aunque no haya cambiado nada?
Lo más probable es que el proveedor de modelos no respondió: se agotó la cuota, hubo un error de red o la cadena de proveedores alternos no estaba disponible. Ese mensaje es del enrutado, no del script. El archivo de salida de ese trabajo en esa fecha contiene el error real. Si el script se ejecutó bien y el fallo es del modelo, la corrección es mover el trabajo al modo sin agente.
¿Cómo evito que una sesión se coma todo el presupuesto?
Con topes puestos antes de que hagan falta y no después. En concreto, profundidad de delegación en uno, entre dos y tres subagentes simultáneos, y un número de iteraciones que corresponda a la duración máxima que le quieres permitir a una tarea. Y la revisión de consumo, que es la que de verdad avisa: si una sesión pasa de cierto tamaño, es que el flujo está dando vueltas y hay que mirar por qué.
¿En qué se diferencian una skill y la memoria?
La memoria guarda hechos que el agente debe tener presentes. Una skill guarda un procedimiento que el agente carga cuando la situación lo amerita. Un hecho como “el servidor de producción es el 10.0.0.5” es memoria. Un procedimiento como “este es el orden de pasos para publicar un post sin romper el gate de publicación” es una skill. Confundirlos produce duplicados y contexto de más.
¿Cómo hago que el agente no me pregunte cosas obvias?
Primero identifica de dónde viene la pregunta. Si es un dato que le falta, guárdalo en la memoria siempre activa y deja de preguntar. Si es el modo de aprobación, cambia el modo y añade los comandos concretos a la lista blanca, que es lo que permite el patrón en vez de un comodín. Si es una tarea recurrente que haces igual cada vez, la respuesta correcta es otra: convertirla en skill.