Cómo crear skills propias en Hermes: SKILL.md y carga progresiva
La diferencia entre un asistente que responde bien y uno que responde bien y además sabe las cosas que tú sabes no está en el modelo. Está en un archivo de texto con un nombre en minúsculas, guardado en una carpeta que se llama skills. Cuando le pides a Hermes que revise un post que acaba de publicar, lo que hace es leer un documento con el procedimiento exacto, seguirlo paso a paso y no improvisar. Eso es una skill, y es la pieza que más rendimiento da por byte invertido de todo el sistema.
Una skill es, en el fondo, un documento de conocimiento que se carga bajo demanda. No un plugin, no una extensión del agente: un archivo. Y esa simplicidad es lo que la hace útil, porque puedes escribir una en diez minutos sin saber programar, versionarla en un repositorio y compartirla con el mismo mecanismo que usas para compartir código. Este post es el tutorial completo: la anatomía de una skill, cómo se escribe el disparador que decide cuándo cargarla, cómo se organiza el detalle para que no te cueste contexto, y los cuatro errores que hacen que una skill mal escrita no se cargue nunca.
TL;DR — Lo que vas a tener al final
- Tiempo de setup: 20 minutos para el primer esqueleto y 30 más para dejarlo con las cuatro secciones que importan
- Requisitos: un editor de texto y una carpeta. No hace falta saber programar; los scripts son opcionales
- Resultado: una skill propia funcionando, con el disparador escrito para que el agente la cargue sola, y el detalle organized en carga progresiva
- Troubleshooting: si la skill nunca se carga, el problema está en la primera línea de la descripción, no en el contenido
Qué es una skill y dónde vive
Hermes define las skills como documentos de conocimiento que el agente carga cuando los necesita, siguiendo un patrón de carga progresiva para minimizar el uso de tokens, y compatibles con el estándar abierto agentskills.io. Todas viven en ~/.hermes/skills/, que es el directorio principal y la fuente de verdad. Ahí se copian las skills que vienen con la instalación, ahí llegan las que se instalan desde el catálogo público y ahí terminan las que escribe el propio agente.
Ese diseño tiene una consecuencia útil: una skill es un archivo de texto. Se edita con lo que Uses, se versiona con Git y se revisa como código. No hay compilación, ni dependencias, ni un ciclo de despliegue.
El SKILL.md y sus cuatro secciones obligatorias
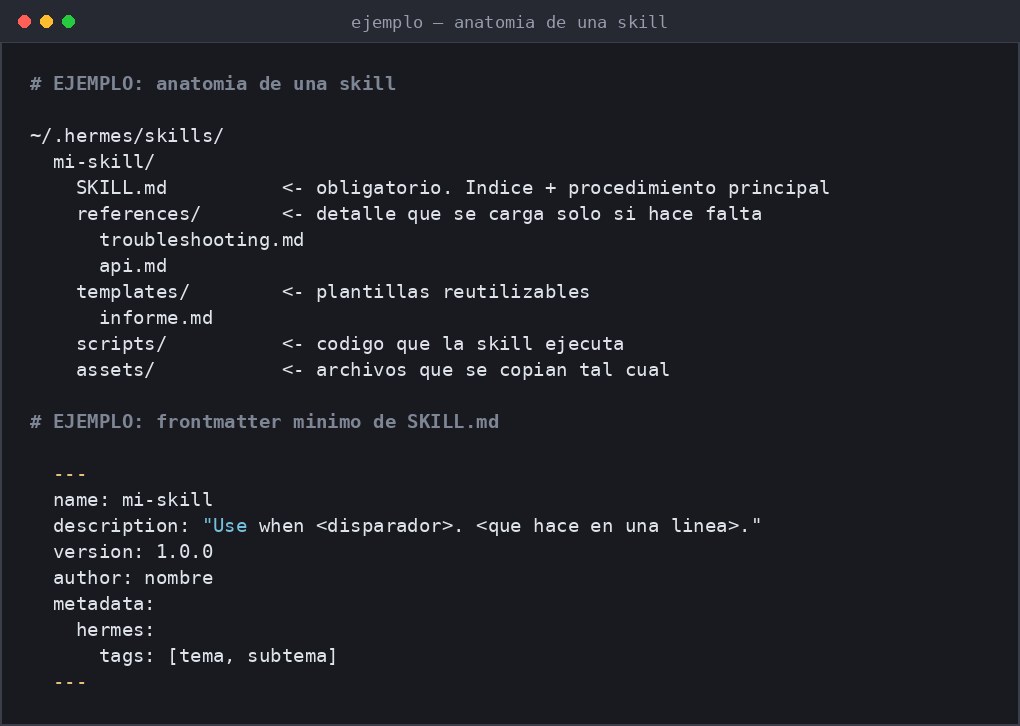
El archivo SKILL.md tiene un frontmatter y un cuerpo en Markdown. El frontmatter es YAML y empieza con ---. Lo mínimo que funciona es esto:
---
name: mi-skill
description: "Use when <disparador>. <que hace en una linea>."
version: 1.0.0
author: tu-nombre
metadata:
  hermes:
    tags: [tema, subtema]
---
# mi-skill
Una frase con el objetivo.
## Cuando usarla
Disparadores concretos.
## Procedimiento
Pasos numerados, con los comandos reales.
## Errores comunes
Sintoma -> causa -> correccion.
El nombre va en minúsculas con guiones, sin espacios. Y el description tiene un formato que conviene respetar porque es el texto que decide si la skill se carga. La primera frase tiene que decir cuándo usarla y la segunda qué hace. Un ejemplo del estilo correcto: “Use when the user asks to publish a blog post. End-to-end content pipeline with mandatory quality gates.”
La descripción es el disparador, y ahí se decide todo
Este es el punto que más se malinterpreta. La descripción no es documentación para humanos: es lo que el agente lee para decidir si tu skill le sirve. Si la descripción no contiene las palabras que usaría alguien al pedirte la tarea, la skill no se carga nunca. Y da igual cuántas líneas excellentes tenga el procedimiento: si no hay coincidencia con el disparador, no se lee.
La regla práctica que sigo es escribir la descripción pensando en la frase que el usuario diría, no en lo que la skill hace por dentro. Si el usuario dice “revisa los posts que se publicaron hoy”, la descripción tiene que contener algo como “use when the user asks to review or audit published posts”, no “pipeline de validación editorial con gates”. Pon las dos: el disparador en la primera frase y la función en la segunda.
Hay un detalle de la implementación que conviene tener presente: el sistema pide que los primeros 57 caracteres de la descripción sean un disparador autocontenido. En la práctica, lo que hace falta es que la primera frase se entienda sin leer el resto.
La carga progresiva es lo que hace que una skill sea usable
La idea central del diseño es que SKILL.md sea un índice, no un manual. El agente carga el índice, decide si necesita el detalle, y entonces carga solo el archivo concreto que le sirve.
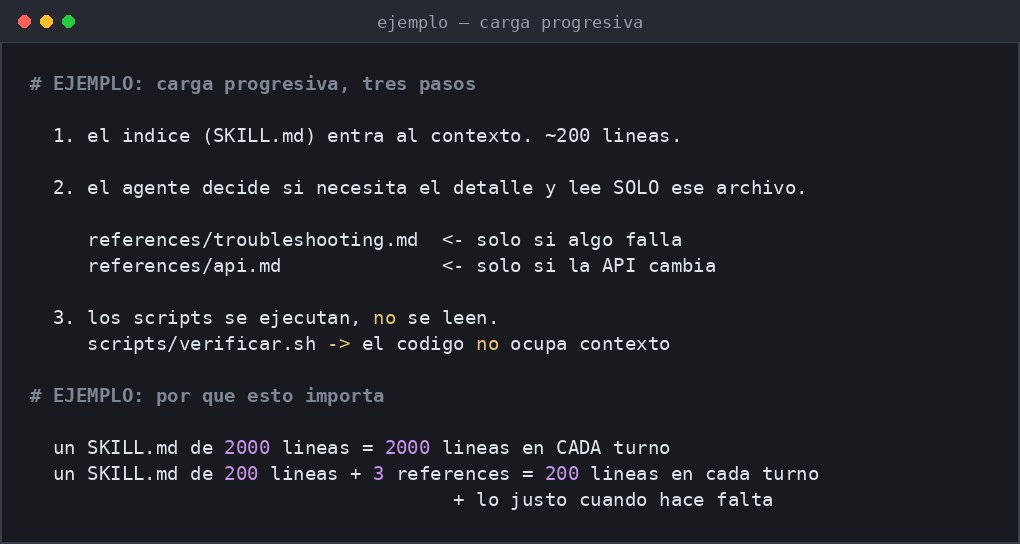
El cálculo es simple y por eso la estructura de carpetas no es opcional. Un SKILL.md de dos mil líneas significa dos mil líneas de contexto en cada turno de cada sesión donde la skill está disponible. Un SKILL.md de doscientas líneas más tres archivos de referencia significa doscientas líneas siempre, y el resto solo cuando el agente decide que lo necesita.
Las carpetas de apoyo tienen papeles distintos y conviene no mezclarlas. references/ es documentación de consulta: la API de un servicio, la lista de errores conocidos, el procedimiento de recuperación. templates/ son plantillas que se copian y se rellenan. scripts/ es código que la skill ejecuta y que, por lo tanto, no ocupa contexto: el agente lo invoca y lee el resultado, no el código. Y assets/ son archivos que se copian tal cual, sin procesar.
Crear una skill: tres vías
La primera es escribirla a mano. Creas la carpeta dentro de ~/.hermes/skills/, el archivo SKILL.md y ya está. Es la vía más rápida para algo personal.
La segunda es instalarla del catálogo. El subcomando de skills trae todo el ciclo: browse para ver lo que hay, search para buscar, inspect para ver una skill antes de instalarla sin ejecutarla, install para instalarla, check para buscar actualizaciones, update para aplicarlas, audit para volver a pasar el análisis de seguridad y uninstall para quitarla. El inspect es el que más uso: ver qué hace algo antes de que el agente lo use evita sorpresas.
La tercera es dejar que el agente la escriba. Hermes tiene una herramienta específica para crear y modificar skills, y el agente puede Inclusive añadir skills nuevas cuando aprende un procedimiento que no tenía. Eso es lo que distingue a Hermes de un asistente que solo lee instrucciones: el procedimiento se guarda. Y hay dos interruptores para controlar ese comportamiento, ambos en la sección skills de la configuración: write_approval, que hace que el agente pregunte antes de escribir una skill, y guard_agent_created, que controla si puede crearlas sin intervención.
# EJEMPLO: ver las skills instaladas
hermes skills list
# EJEMPLO: buscar antes de escribir una a mano
hermes skills search postgres
# EJEMPLO: ver una skill sin instalarla
hermes skills inspect nombre-de-la-skill
# EJEMPLO: recargar los permisos y ver que una skill quedo bien montada
hermes skills list | grep mi-skill
Cada skill es un comando de barra
Una vez instalada, cada skill queda disponible como comando: escribes /nombre-de-la-skill y se carga. Solo el nombre carga la skill y deja que el agente te pregunte qué necesitas; con argumentos, la skill se carga y trabaja con ellos.
También se pueden encadenar varias en un mismo mensaje: todos los tokens /skill iniciales, hasta cinco, se cargan, y el resto del mensaje se convierte en tu instrucción. Eso permite escribir algo como /revision-de-contenido /auditoria-de-servidor revisa el host del cliente y tener cargadas las dos habilidades antes de que el agente empiece a trabajar.
Un detalle fino: el parser se detiene en el primer token que no sea una skill instalada. Eso significa que un argumento que empieza con barra, como una ruta, no se traga nada.
Compartir skills sin registro ni servidor
Para compartir hay un mecanismo que no necesita ni servidor ni registro ni pipeline de publicación: un tap. Un tap es simplemente un repositorio de GitHub, público o privado, con una carpeta skills/ y un SKILL.md por subcarpeta. Se añade con hermes skills tap add propietario/repo y a partir de ahí las skills de ese repositorio están disponibles para instalar.
La estructura del tap es sencilla: cada skill en su propia carpeta, y dentro de ella el SKILL.md obligatorio más las carpetas opcionales de references/, templates/, scripts/ y assets/, que se descargan junto con el índice al instalar. Las carpetas cuyo nombre empieza por punto o por guion bajo se ignoran, lo que sirve para dejar notas o pruebas sin que se conviertan en skills.
Los cuatro errores que hacen que una skill no funcione
En orden de frecuencia, y ninguno se detecta porque la skill simplemente “no hace nada”.
1. La descripción no contiene el disparador
La skill es perfecta y nunca se carga, porque su descripción habla de lo que hace y no de cuándo hay que usarla. Es el error más común y el más barato de arreglar.
2. Todo el detalle dentro del SKILL.md
Funciona, pero paga el coste en cada turno de cada sesión. Con diez skills cargadas a la vez, el contexto se infla y el agente empieza a resumirse cosas que no debía. El índice va en SKILL.md y el detalle, a references/.
3. Los archivos de referencia no están enlazados
Un references/ que el SKILL.md no menciona explícitamente es un archivo que el agente no va a leer, porque no tiene forma de saber que existe. El índice tiene que decir “para el caso de error de permisos, lee references/permisos.md“.
4. El nombre choca con otra skill
El nombre se convierte en el comando, así que dos skills con el mismo nombre se pisan y el agente carga la que encuentra primero. Cuando instales varias, revisa la lista y desambigua los nombres antes de que sea un problema.
Preguntas frecuentes
¿Cuál es la diferencia entre una skill y un plugin?
Una skill es un documento de conocimiento: instrucciones, referencias y scripts opcionales, sin nada que ejecutar fuera del agente. Un plugin extiende el agente con herramientas nuevas o comportamiento en el arranque. La skill vive en la carpeta de skills y se carga bajo demanda; el plugin vive en su propia carpeta y se activa con la sesión. Casi todo lo que necesitas para documentar un procedimiento es una skill.
¿Cómo sé si mi skill se está cargando?
Los tres indicadores. El primero, el nombre de la skill aparece en la lista de instaladas. El segundo, si la invocas con barra, el agente la carga y trabaja con ella. El tercero y más útil: en la conversación, el agente menciona el procedimiento. Si nunca lo menciona, el problema casi siempre es el disparador de la descripción.
¿Puedo hacer que el agente no escriba skills sin mi permiso?
Sí, y es lo que yo haría si el equipo es más de una persona. El ajuste skills.write_approval hace que el agente pregunte antes de crear o modificar una skill, y skills.guard_agent_created controla el alcance de esa protección. Con la aprobación activa, el agente sigue pudiendo aprender, pero te pide permiso antes de dejar algo escrito.
¿Cuántas skills debería tener instaladas?
No hay un número, hay un criterio: cada skill que instalas compite por el mismo mecanismo de disparo que las demás. Con muchas skills de tema parecido, el agente tiene más dificultad para elegir y termina cargando la equivocada. Mejor pocas y precisas, con nombres que no se pisen y descripciones que no se solapen.
¿Cómo comparto una skill con otra persona?
Un tap: un repositorio de GitHub con una carpeta skills y un SKILL.md por subcarpeta, añadido con hermes skills tap add propietario/repo. No hay servidor de por medio ni registro. Si el repositorio es privado, hace falta un token de GitHub con permiso de lectura. También sirve para versionar tus propias skills y tener el historial de cambios.