Qué es un agente de IA y en qué se diferencia de un chatbot
El ejemplo que se repitió durante años de “IA conversacional” era una caja de texto: le escribías una pregunta, el modelo te contestaba un párrafo y ahí terminaba la interacción. Eso es un chatbot, y funciona bien para lo que hace. El problema aparece en cuanto le pides algo que exige consultar el estado real de una máquina: saber si el servicio está caído, qué dice el log de las últimas dos horas, cuál es la versión instalada de una dependencia. El modelo no puede inventar esa respuesta porque no tiene acceso a nada, y una respuesta inventada con tono seguro es justo el tipo de error que después cuesta una hora de producción.
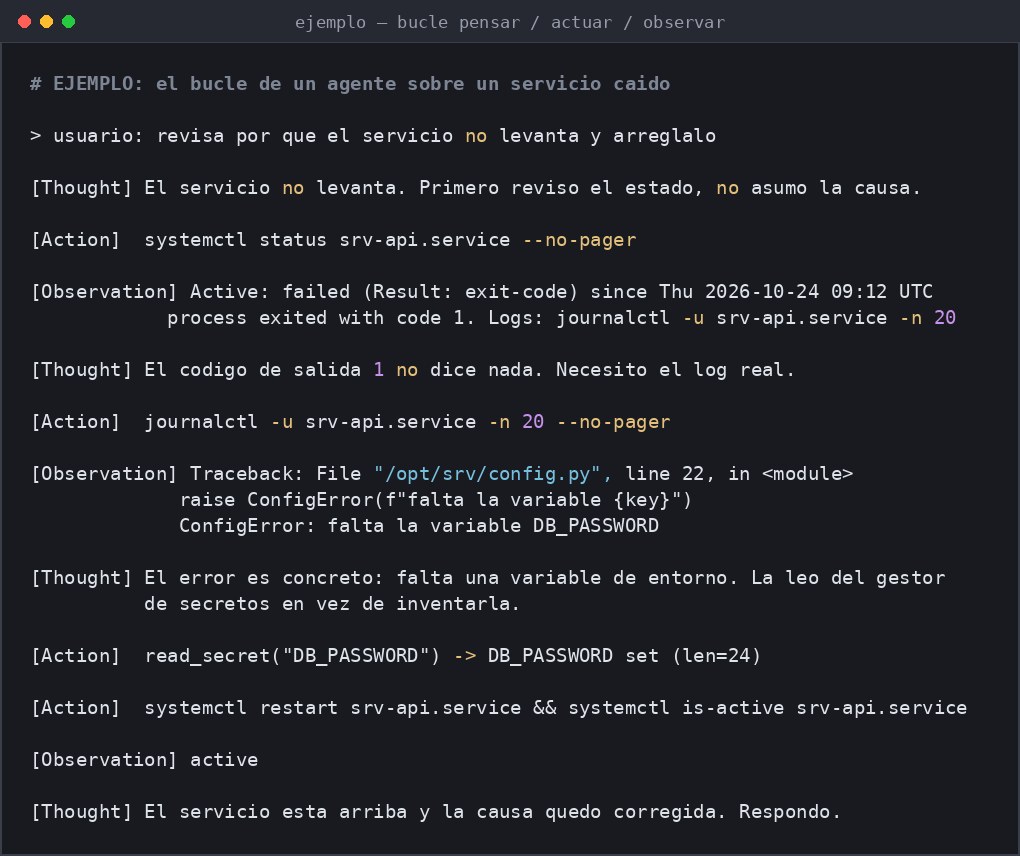
Un agente resuelve eso con una diferencia conceptual, no con más inteligencia: le da al modelo herramientas para observar y actuar sobre un sistema real, y lo deja decidir en cada paso cuál usar. Es la diferencia entre un modelo que describe cómo se arregla un servicio caído y otro que lee el estado del servicio, encuentra la causa en el log, corrige la variable que falta y te confirma que quedó arriba. Este post es el mapa de esa diferencia: qué separa a un agente de un chatbot, cómo funciona el bucle por dentro, qué falla en la práctica y cuándo no conviene montar nada de esto.
TL;DR — Lo que vas a tener al final
- Tiempo de setup: 25 minutos de lectura y dos capturas de terminal para entender el bucle completo y ver los topes que lo mantienen acotado
- Requisitos: saber qué es un LLM con called function y tener a mano un servidor al que quieras conectar una herramienta real; nada de código obligatorio
- Resultado: un criterio propio para distinguir un agente de un workflow con nombre elegante, y una lista de los cinco patrones de workflow que cubren el 90% de los casos que dicen “necesito un agente”
- Troubleshooting: si tu agente se cicla, el problema casi nunca es el modelo: es que falta un tope de iteraciones o un criterio de terminación explícito
Qué es un chatbot y en qué se queda corto
Un chatbot es un modelo de lenguaje expuesto detrás de una interfaz de entrada y salida. La unidad de interacción es el turno: la persona escribe, el modelo contesta, la persona escribe otra vez. Todo el estado de la conversación vive en el prompt que se va acumulando, y el modelo no puede hacer nada más que producir texto.
Ese diseño funciona para redactar, resumir, traducir o responder preguntas sobre un documento que le pasaste. Y funciona mal en cuanto el trabajo necesita una de estas tres cosas:
- Observar algo que no está en el prompt. El estado del servicio, el contenido de un log, la versión de un paquete, el resultado de una consulta a una base de datos. El modelo no puede ver nada que no esté pegado en el prompt.
- Actuar. Correr un comando, escribir un archivo, reiniciar un servicio, abrir un ticket. Un chatbot que dice “puedes ejecutar
systemctl restart srv” te devuelve el trabajo a ti. - Decidir el siguiente paso. Un chat lineal siempre avanza en el orden en que tú escribiste. Un agente decide, en cada vuelta, si necesita otra observación, si ya tiene la respuesta o si debe cambiar de estrategia.
Esa tercera diferencia es la que importa de verdad, y es la que separa a un agente de un workflow. Un workflow tiene el camino grabado: el código dice “primero el paso A, después, según el resultado, el paso B”. Un agente decide en runtime qué hacer, con el modelo como quien elige. Es la distinción que Anthropic formalizó en su guía de construcción de agentes: los workflows son sistemas donde los LLM y las herramientas se orquestan por rutas de código predefinidas, mientras que los agentes son sistemas donde el LLM dirige dinámicamente su propio proceso y el uso de herramientas.
Las cinco piezas de un agente real
La definición operativa que más me sirve es la de “LLM aumentado”: un modelo de lenguaje al que se le agrega capacidad de recuperación, herramientas y memoria. Los modelos actuales no solo reciben esas capacidades: generan sus propias consultas de búsqueda, eligen la herramienta adecuada y deciden qué información merece la pena retener. Eso último es lo que separa a un agente de un simple Enhanced LLM con una función de búsqueda atada.
Sobre esa base, un agente que funciona en producción tiene cinco piezas. Ninguna es opcional.
1. El modelo como motor de razonamiento
El modelo no “sabe” hacer sysadmin. Su trabajo es decomponer el problema, decidir qué herramienta usar con qué argumentos, interpretar lo que vuelve y decidir si ya terminó. Esa última decisión, la de parar, es la más difícil de hacer bien y la que más se olvida.
2. Herramientas con descripciones honestas
La calidad de un agente está limitada por la calidad de la interfaz que le das. Anthropic lo dice de forma bastante directa en su guía: el tiempo que uno mismo dedica a optimizar las herramientas suele ser mayor que el dedicado al prompt general, y una buena definición de herramienta incluye ejemplos de uso, casos límite, requisitos del formato de entrada y límites claros frente a las otras herramientas. El truco más rentable que mencionan es el poka-yoke: cambiar los argumentos para que sea difícil equivocarse. En su agente para SWE-bench, hacer que la herramienta exigiera rutas absolutas —porque el modelo se equivocaba con rutas relativas después de cambiar de directorio— eliminó el error por completo.
Ese detalle del camino absoluto no es un detalle. Es la diferencia entre un agente que falla de forma ruidosa y uno que falla de forma silenciosa, y esa segunda es la que te cuesta el día.
3. Memoria con dos planos
Hay memoria de trabajo (el contexto de la conversación actual) y memoria persistente (lo que sobrevive entre sesiones). Un agente serio separa las dos. Si todo vive en el contexto, cada sesión empieza de cero y el costo por token se dispara sin que lo notes. Si todo es persistente, el agente arrastra contexto viejo que ya no aplica y toma decisiones con información caduca.
4. Un criterio de terminación explícito
Un bucle sin tope no termina. La forma más barata de acotarlo es un máximo de iteraciones; la más correcta es una condición de salida explícita que el propio agente pueda evaluar. Si no tienes ninguna de las dos, el agente sigue hasta que se acaba el presupuesto de tokens, y cuando eso pasa suele ser en medio de una tarea a medio hacer.
5. Registro de todo el recorrido
Si el agente no deja rastro de qué herramientas invocó, con qué argumentos y qué obtuvo, no hay forma de depurar cuando la respuesta final es incorrecta. Es la diferencia entre “el agente dijo que estaba bien” y “el agente ejecutó estos seis comandos y yo puedo verlos”.
El bucle: pensar, actuar, observar
La forma canónica de organizar todo esto se llama ReAct, del paper ReACT: Synergizing Reasoning and Acting in Language Models de Yao y otros, publicado como arXiv 2210.03629 en 2022 y presentado en ICLR 2023. La idea central es que el razonamiento y la acción no se estudian por separado sino intercalados: el modelo produce un razonamiento, elige una acción, recibe la observación y vuelve a razonar con esa información nueva dentro del contexto.
El mecanismo se describe con tres verbos que se alternan:
- Thought. El razonamiento verbalizado, que descompone el problema grande en subtareas manejables.
- Action. La invocación de una herramienta, con sus argumentos concretos.
- Observation. Lo que la herramienta devolvió, que vuelve al contexto e informa el siguiente razonamiento.
El resultado es un bucle que se cierra sobre sí mismo hasta que el agente decide que ya tiene la respuesta. En la práctica, cada vuelta tiene esta forma:
Lo interesante del paper es que no es una construcción teórica. Aplicado a HotpotQA y Fever, el mecanismo “supera problemas prevalentes de alucinación y propagación de errores en el razonamiento tipo chain-of-thought, interactuando con una simple API de Wikipedia”, según el resumen del propio trabajo. En los benchmarks de decisión interactiva ALFWorld y WebShop, el paper reporta un margen absoluto de éxito de 34% y 10% respectivamente frente a métodos de imitación y aprendizaje por refuerzo, y todo eso con apenas uno o dos ejemplos en el contexto.
El dato del 34% importa por una razón práctica: el bucle no solo mejora la respuesta, la hace interpretable. Puedes leer el recorrido y ver dónde se equivocó. Con un chatbot, si la respuesta está mal, no hay nada que inspeccionar.
Cuándo no necesitas un agente
Esta es la parte que la mayoría de las guías de agentes omiten, y es la que más dinero ahorra. La recomendación de Anthropic es directa: hay que buscar la solución más simple posible y solo aumentar la complejidad cuando haga falta, lo que puede significar no construir sistemas agénticos en absoluto. Los sistemas agénticos suelen cambiar latencia y costo por mejor desempeño en la tarea, y esa decisión hay que tomarla a conciencia.
En la práctica, un agente casi nunca es la respuesta correcta cuando el flujo se puede expresar como pasos fijos. Si tu tarea es “revisar estos cinco archivos, extraer el campo X y gerar un CSV”, eso es un workflow: código que llama al modelo cinco veces. Un agente ahí solo agrega variabilidad y gasto.
La regla práctica que uso:
- Si el camino se puede dibujar de antemano, escribe el workflow. Cinco llamadas al modelo en un bucle
forcuestan una fracción de lo que cuesta un agente y se comportan igual en cada ejecución. - Si el camino depende de lo que se descubra en el camino, ahí sí necesita un agente. “Arregla lo que esté roto” es el caso canónico: no sabes de antemano qué comandos vas a necesitar.
Y hay un tercer motivo, el más importante de todos en un entorno de producción: un agente es más difícil de acotar. Un workflow se puede probar con entradas fijas y comparar salidas. Un agente depende del modelo, del contexto, del estado del mundo y del azar. Por eso empieza siempre con un tope de iteraciones y un presupuesto explícito, y por eso nunca lo dejas correr sin techo en un servidor de producción.
# Ver los limites que estan puestos ahora mismo
hermes config show | grep -E "max_iterations|max_concurrent_children|max_spawn_depth"
# Cambiar uno sin abrir el YAML a mano
hermes config set max_iterations 60
# Comprobar que el valor quedo escrito
hermes config get max_iterations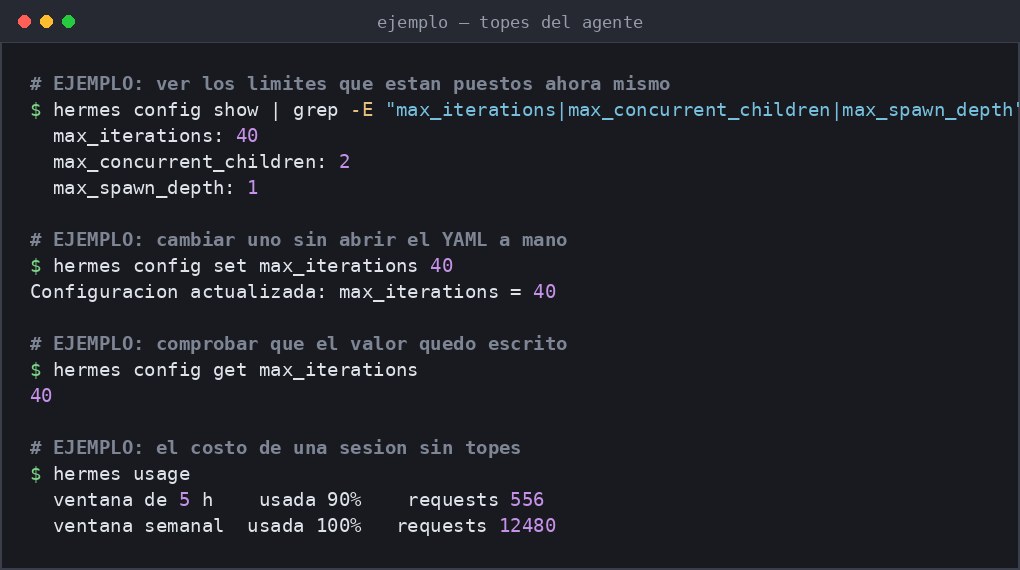
Qué falla de verdad cuando un agente se equivoca
Después de poner varios en producción, los fallos que se repiten son siempre los mismos, y ninguno es “el modelo es malo”.
El bucle que no para
El agente no encuentra lo que busca, reintenta con una variación, vuelve a fallar y repite hasta agotar el presupuesto. La causa casi siempre es una herramienta mal definida o un error de ruta, no de razonamiento. La defensa es un tope de iteraciones y un log que muestre cada invocación.
El contexto que se desborda
Cada observación entra al contexto y nunca sale. Una sesión larga termina con el 90% del contexto siendo salidas de herramientas que ya no importan. La mitigación correcta no es recortar el historial a lo bruto: esrophes resumir lo que ya se resolvió y conservar el detalle solo de lo que sigue abierto.
La confianza que crece sin evidencia
Un agente que ya hizo diez llamadas con éxito empieza a asumir que la undécima también va a funcionar, y deja de verificar. Es un sesgo real del bucle, no una falla del modelo. Se mitiga con verificación explícita al final de la cadena: el agente no responde “listo” hasta que una herramienta le confirma el estado.
El costo invisible de la recursión
Un agente que delega en subagentes, y esos subagentes delegan otra vez, multiplica el contexto enviado. En una revisión de contenido con nueve subagentes en un árbol de cuatro niveles, el consumo llegó a millones de tokens en dos horas: seis de los nueve hijos murieron por compresión de contexto y el resto chocó con el error 429 de límite del plan. Nada de eso era un problema de calidad del modelo. Era un problema de profundidad sin tope, y la lección fue tan simple comokz: max_spawn_depth: 1 y un límite de concurrencia bajo evitan el 90% de ese daño.
Cómo saber si lo que tienes es un agente o un workflow
Hay una prueba de una línea. Hazte esta pregunta: si el resultado del paso anterior cambia, ¿el siguiente paso sigue siendo el mismo?
Si la respuesta es sí, tienes un workflow: el camino está grabado y el modelo es un lector con opinion. Si la respuesta es no, tienes un agente: el modelo está eligiendo. Casi todas las implementaciones que se venden como agentes son workflows con un bucle de llamadas al modelo en lugar de una ruta fija, y esa diferencia importa por una razón muy concreta: el workflow se puede depurar, reproducir y testear; el agente hay que observarlo trabajar.
La propia guía de Anthropic lo dice en la misma línea: si usas un framework, asegúrate de entender qué hay por debajo, porque las suposiciones incorrectas sobre el framework son una fuente común de error en los clientes.
Preguntas frecuentes
¿Cuál es la diferencia real entre un chatbot y un agente?
El chatbot produce texto a partir de lo que hay en el prompt. El agente tiene herramientas para observar y actuar sobre un sistema real, y decide en cada paso cuál usar y cuándo parar. La diferencia no es de modelo: es de acceso a herramientas y de quién controla el siguiente paso.
¿Necesito un framework para montar un agente?
No necesariamente. La recomendación de Anthropic es empezar con la API del modelo directamente: la mayoría de los patrones se implementan en pocas líneas, y los frameworks agregan capas de abstracción que dificultan entender qué pasa por debajo. Si usas uno, asegúrate de entender su implementación antes de confiarle el comportamiento.
¿Cuándo un agent loop se cicla y cómo lo evito?
Se cicla cuando el agente no logra la observación que necesita y reintenta con variaciones cada vez. El tope de iteraciones es la red de seguridad barata, pero el arreglo de fondo es una herramienta bien definida: si una llamada falla por un motivo concreto (ruta inexistente, flag incorrecto), el error devuelto debería decirlo con claridad para que el modelo cambie de estrategia en lugar de repetir.
¿Es mejor usar function calling o un loop ReAct?
Depende de lo predecible de la tarea. Con function calling, el modelo elige entre herramientas disponibles pero no decide el orden ni cuándo iterar: es más rápido, más barato y más simple. ReAct aporta la visibilidad del razonamiento paso a paso, que compensa cuando la tarea es dinámica o inesperada, y paga el costo en tokens de cada vuelta.
¿Cómo sé si mi agente está bien configurado sin gastarme el presupuesto?
Mide tres cosas antes de correr nada largo: el número de iteraciones promedio por tarea exitosa, el porcentaje de tareas que terminan por criterio de terminación y no por tope, y el costo en tokens por tarea. Si el primer número es alto o el segundo es bajo, el problema está en la definición de las herramientas o en el criterio de terminación, no en el modelo.