Cómo se diseña una herramienta para un agente de IA
Cuando alguien me pregunta qué separa a un agente que funciona de uno que se equivoca, la respuesta esperada casi nunca es “el modelo”. Es la interfaz. El modelo es el motor: el mismo motor rinde distinto según cómo le expongas lo que puede hacer. Y esa interfaz no es el prompt, no es el JSON del esquema y no es la lista de nombres de función. Es el conjunto de herramientas que el agente invoca, con sus argumentos, sus validaciones y, sobre todo, sus mensajes de error.
En su guía de construcción de agentes, Anthropic cuenta que en el agente que desarrollaron para SWE-bench dedicaron más tiempo a optimizar las herramientas que el prompt general, y que uno de los cambios con más impacto fue hacer que la herramienta exigiera rutas absolutas: el modelo se equivocaba con rutas relativas en cuanto había cambiado de directorio de trabajo, y al cambiar el requisito el modelo dejó de equivocarse por completo. Ese detalle es la mitad de este post: no se trata de que el modelo sea torpe, se trata de que la herramienta le dejaba equivocarse.
TL;DR — Lo que vas a tener al final
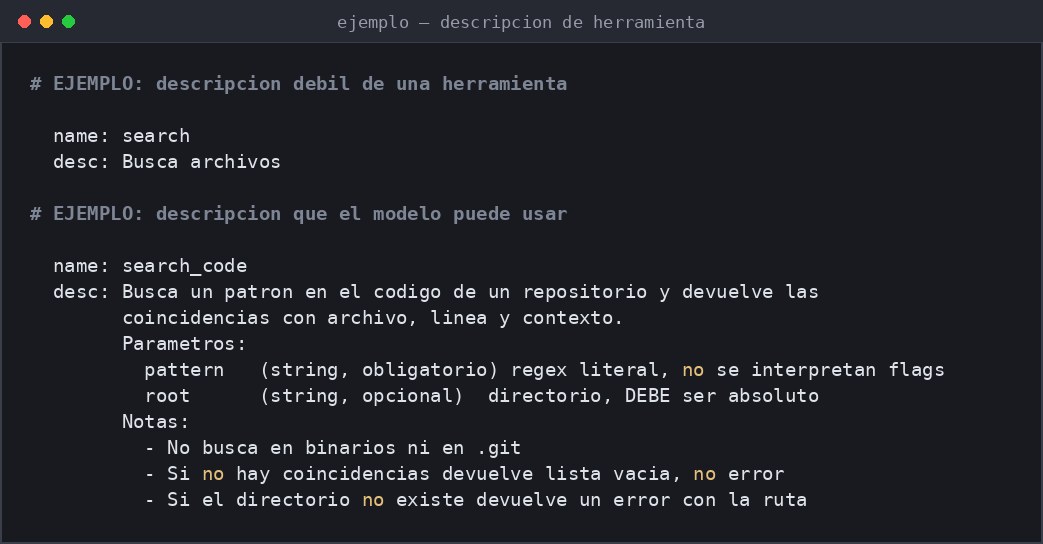
- Tiempo de setup: 30 minutos de lectura y dos capturas con la diferencia entre una herramienta mal descrita y una que el modelo puede usar
- Requisitos: saber qué es un called function y tener a mano una herramienta propia que puedas modificar; el resto es criterio, no código
- Resultado: siete reglas concretas para diseñar herramientas, un criterio para escribir errores que el agente pueda corregir solo, y una forma de probar tus herramientas sin un suite de tests
- Troubleshooting: si tu agente reintenta la misma llamada con el mismo error, el problema no es que no entienda: es que tu mensaje de error no le dice qué cambiar
Por qué la interfaz manda sobre el modelo
La idea de que el modelo “razona” sobre el mundo y elige herramientas es correcta, pero incompleta. Lo que el modelo hace es encajar lo que leyó en un patrón que ya conoce. Cuando ve el catálogo de herramientas con sus descripciones, está leyendo documentación y decidiendo a qué patrón se parece lo que necesita. Si la documentación es ambigua, el modelo no tiene forma de saber que lo hizo mal: no hay ningún canal por el cual eso se reporte.
Por eso Anthropic propone pensar en esto como una interfaz entre el agente y la computadora, análoga a la interfaz humano-computador pero para un consumidor que no se equivoca por descuido sino por ambigüedad. Y de ahí salen las reglas.
Regla 1: la descripción es un docstring, no un nombre
El nombre de la herramienta no es la documentación. La descripción sí. Y tiene que estar escrita para alguien que conoce tu sistema pero no tu manera de pensar: el mismo trato que le darías al docstring de una función para un junior que acaba de llegar al equipo.
Una buena descripción incluye cuatro cosas, según la propia guía: ejemplos de uso, casos límite, requisitos del formato de entrada y límites claros frente a las otras herramientas. El último punto se subestima: si tienes cinco herramientas que parecen intercambiables, el modelo va a elegir la que mejor encaje con el nombre, no la que hace lo que necesita. Marcar los límites de cada una es lo que evita que elija mal.
Regla 2: el poka-yoke como método
El poka-yoke es una técnica de la ingeniería de calidad que viene de la industria japonesa: en vez de detectar el error, se diseña el sistema de modo que el error sea difícil de cometer. La guía de Anthropic lo propone explícitamente para herramientas de agentes: cambiar los argumentos para que sea más difícil equivocarse.
El caso que citan es el de las rutas absolutas. Pero el principio generaliza a todo lo que puedes validar de antemano:
- Rutas: si el argumento es una ruta, valídala y expón solo la forma absoluta. Un agente que trabaja en un directorio conocido no debería poder pedir una ruta relativa.
- Enumeraciones: si un argumento tiene tres valores válidos, no aceptes texto libre. Acepta el enum y descarta el resto en la validación.
- Unidades: si un parámetro es un tamaño en bytes, no lo llames
sizey ya: que el nombre diga la unidad, o mejor, que el parámetro venga con una unidad fija y no con la unidad dentro del valor. - Flags incompatibles: si dos opciones no pueden ir juntas, valida esa combinación en el servidor y devuelve un error que diga cuál quitar.
Cada una de estas validaciones es un mensaje que el modelo no va a tener que aprender a fuerza de equivocarse.
Regla 3: deja espacio para que el modelo piense
Esta es la regla que más se ignora porque parece contraintuitiva: hay que darle al modelo más tokens para pensar antes de que escriba. La guía es explícita en que hay que darle tokens para “pensar” antes de que se meta en un callejón sin salida, y que hay que evitar cualquier sobrecarga de formato, como mantener un conteo exacto de miles de líneas de código o hacer que el modelo escape cadenas que él mismo escribe.
En la práctica significa dos cosas. La primera: no le pidas al modelo que produzca JSON complejo con campos anidados cuando un formato plano con separadores hace lo mismo y se parsea sin ambigüedad. La segunda: no le pidas que cuente. Contar líneas, contar caracteres, contar elementos es trabajo de un wc, no de un modelo; si le pides que cuente, vas a obtener un número plausible y equivocado, y el agente va a actuar sobre él.
Regla 4: el formato debe parecerse a lo que el modelo ya vio
La guía recomienda mantener el formato cerca de lo que ocurre naturalmente en texto que el modelo ya ha visto en internet. Esto no es superstición: es el mismo principio que hace que un formato XML le resulte más familiar a un modelo que un formato inventado, y que JSON con nombres en snake_case sea más fácil de producir que JSON con nombres propios en camelCase sin convención previa.
Traducido a tu herramienta: si vas a pedir un parámetro de fecha, usa un formato ISO con horas; si vas a pedir un filtro, usa nombres que la gente realmente escribe. Y si el output va a volver al modelo, que sea texto plano y legible, no una estructura que el modelo tenga que deserializar mentalmente.
Regla 5: el error es parte de la herramienta
Aquí está el cambio con más retorno que conozco. Un error que el agente puede leer y corregir vale más que un error que solo sirve para que el agente se entere de que algo falló. La diferencia no es cosmética: es la diferencia entre que el agente reintente con una variación o que repita la misma llamada tres veces hasta quedarse sin iteraciones.
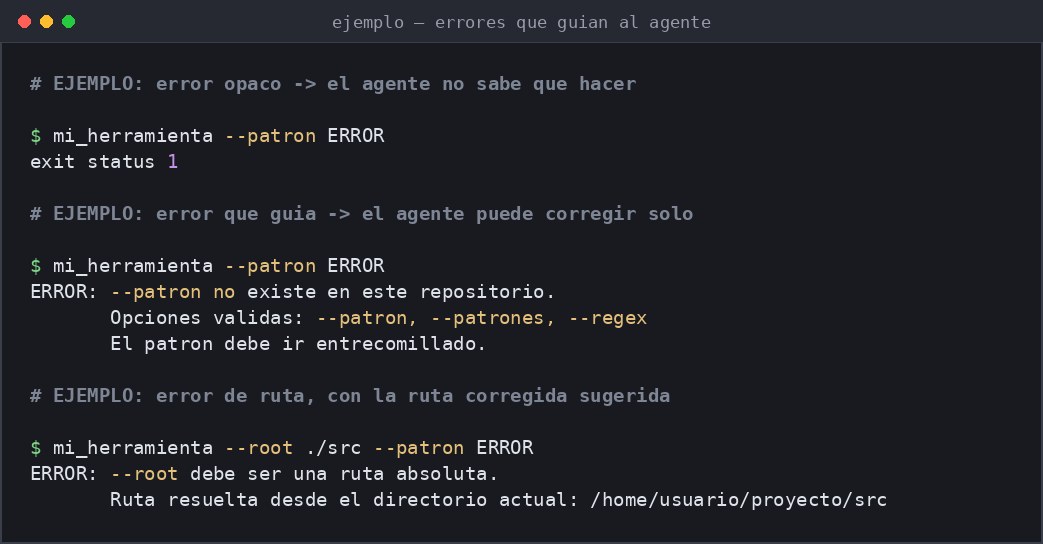
El patrón tiene tres partes. La primera, qué pasó, en una frase. La segunda, qué opciones válidas existen, si las hay. La tercera, qué valor corregirías tú, cuando puedas calcularlo. Ese último punto es el que más rinde: si el agente pidió una ruta relativa y la herramienta puede resolverla contra el directorio actual, el error debe incluir la ruta absoluta ya resuelta. El agente solo tiene que copiarla.
Regla 6: el output debe poder leerse sin effort
El resultado de una herramienta entra completo al contexto del modelo. Eso significa que cada línea que devuelve tiene un costo, y que devolver mil líneas de las que solo importan tres es pagar por información que el modelo va a descartar y que, peor, puede mezclar con la información que sí importa.
La técnica aquí es la misma que se usa en el diseño de interfaces de terminal: paginar, filtrar en el servidor y devolver un resumen con la referencia a cómo pedir el resto. Un agente que recibe quinientas líneas de un log y tiene que decidir cuáles importan va a fallar de forma distinta a uno que recibe las veinte líneas relevantes más el comando para ver las demás.
Regla 7: probar cómo el modelo usa la herramienta
La guía recomienda probar el uso de las herramientas con muchos ejemplos de entrada y observar los errores que comete, corrigiendo la definición en lugar del prompt. Y ese es el punto: no estás probando tu código, estás probando tu documentación.
La forma práctica de hacerlo sin montar un laboratorio es leer los logs de una sesión real y buscar el patrón de reintentos. Cuando el agente repite una llamada cambiando un argumento de forma mecánica, la herramienta no le está enseñando qué cambiar. Esas repeticiones son el test que falló, y la corrección va en la descripción o en el mensaje de error, no en el prompt del sistema.
Un comando que ayuda a encontrar esos casos en el log de una sesión es el siguiente:
# Repetir la misma herramienta con el mismo error es la senal de una
# descripcion deficient: el modelo no sabe que cambiar.
grep -c "tool_error" ~/.hermes/logs/errors.log
# Las herramientas que mas se reintentan son las que hay que rediseñar
grep -oE "tool_name=[a-z_]+" ~/.hermes/logs/errors.log | sort | uniq -c | sort -rn
La lista corta de comprobación
Si tuviera que dejar una sola lista para revisar antes de poner un agente frente a producción, sería esta:
- ¿La descripción dice qué hace, con qué argumentos, qué devuelve y qué límites tiene frente a las otras herramientas?
- ¿Todos los argumentos con formato restrictivo se validan en el servidor y no solo en el prompt?
- ¿El modelo tiene tokens para pensar antes de que la herramienta le exija una salida?
- ¿El formato de salida es texto plano y familiar?
- ¿Cada error dice qué pasó, qué opciones hay y qué valor corregirías tú?
- ¿El output viene filtrado en el servidor en lugar de crudo?
- ¿Probaste las herramientas con entradas reales y revisaste los reintentos?
Preguntas frecuentes
¿Por qué no basta con escribir bien el prompt del sistema?
Porque el prompt orienta la conducta del modelo, pero no le da un canal para descubrir que se equivocó. El modelo solo ve lo que las herramientas devuelven. Si el error es opaco, no hay forma de que el prompt lo compense: la información para corregir no existe en ningún lado. Por eso el mensaje de error es parte del diseño de la herramienta y no un detalle de implementación.
¿Cuántas herramientas debería tener un agente?
Depende de la superposición entre ellas. El problema no es el número sino la ambigüedad: dos herramientas que resuelven cosas parecidas obligan al modelo a adivinar cuál usar, y ahí es donde se equivocan las llamadas. Si tienes quince herramientas con descripciones precisas y límites claros entre ellas, es un problema distinto a tener cinco que se parecen. Cuando tengas dudas, fusiona las que se solapan antes de añadir una nueva.
¿Debo validar los argumentos en el prompt o en el servidor?
En el servidor, siempre. La validación en el prompt es una sugerencia, no una garantía: un modelo puede equivocarse al leerla. Si el servidor acepta un argumento inválido, tarde o temprano alguien lo explota, y el agente que lo invoca con la herramienta equivocada se convierte en el responsable. La validación real es la que se ejecuta igual para todos.
¿Cómo sé si el error de una herramienta es bueno?
Mide los reintentos: si la misma herramienta con el mismo error aparece varias veces en el log, el mensaje no le está dando al modelo lo que necesita. La prueba concreta es simular el mensaje como si fueras el modelo y preguntarte qué cambiarías con esa información. Si la respuesta es “no sabría”, el mensaje está mal.
¿Vale la pena invertir en herramientas antes que en un modelo mejor?
En la mayoría de los casos sí, y por un orden concreto: primero herramientas correctas con un modelo decente, y después modelo mejor con herramientas ya afinadas. Cambiar de modelo es una decisión de una línea; rediseñar cinco descripciones y tres validadores es trabajo de horas. Y el retorno de lo segundo suele medirse en reintentos eliminated, que es donde se pierde el presupuesto de un agente.