Agente o workflow: cómo decidir la arquitectura del sistema
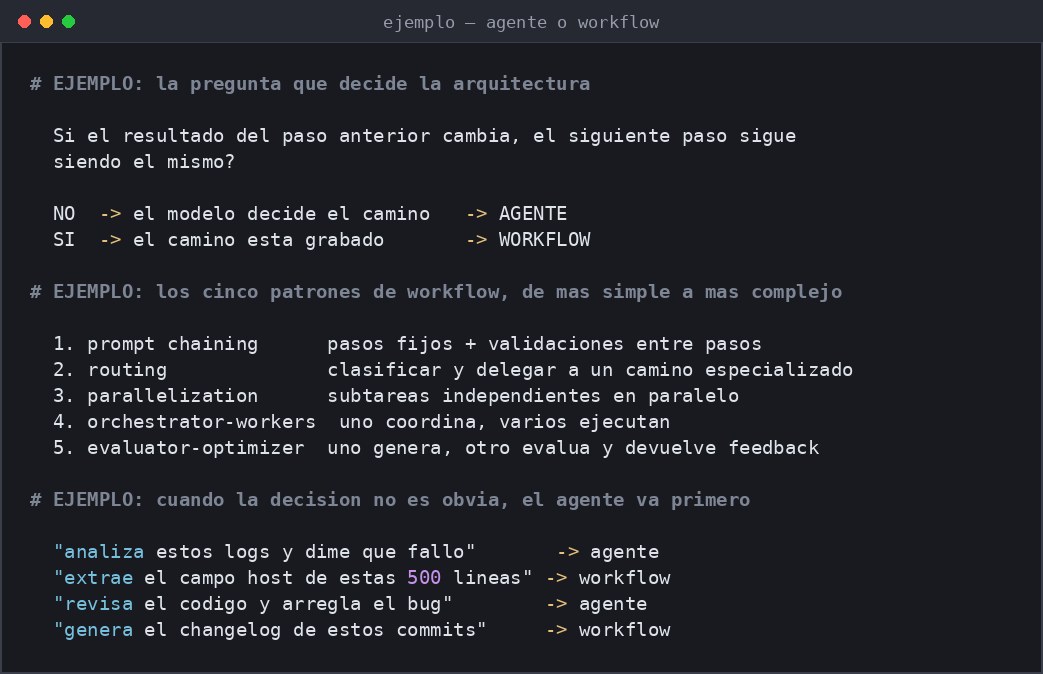
Hay una pregunta que separa dos arquitecturas por completo, y cabe en una línea: si el resultado del paso anterior cambia, ¿el siguiente paso sigue siendo el mismo? Si la respuesta es sí, tienes un workflow. Si es no, tienes un agente. No hay una tercera categoría, aunque el marketing de las herramientas tiende a llamar “agente” a cualquier cosa que llame a un modelo en bucle.
La razón por la que importa no es el marketing, es la operación. Un workflow con el camino grabado tiene un fallo predecible: si hoy procesa mil entradas y falla en tres, mañana falla en las mismas tres y las puedo contar. Un agente con el modelo decidiendo tiene un fallo variable: el mismo conjunto de entradas puede producir tres rutas distintas en tres ejecuciones, y la única forma de saber si va a funcionar es correrlo y mirar. En un entorno donde el error se paga en tiempo de producción, esa diferencia pesa mucho más que la promesa de “autonomía”.
TL;DR — Lo que vas a tener al final
- Tiempo de setup: 30 minutos de lectura y dos capturas con la decisión y los dos flujos comparados
- Requisitos: saber qué es un called function y tener una tarea tuya en mente que hoy resolves a mano
- Resultado: los cinco patrones de workflow ordenados por complejidad, cuándo cada uno basta, y una tabla para decidir sin adivinar
- Troubleshooting: si tu agente falla de forma distinta cada vez, no es que esté fallando: es que estás pagando variabilidad por una tarea que no la necesitaba
La decisión, en dos preguntas
La primera pregunta es si el camino se puede dibujar de antemano. “Extraer el campo host de estas quinientas líneas” es un camino: leer, buscar, devolver. “Revisar este código y arreglar el bug” no lo es: no sabes de antemano qué comandos vas a necesitar ni en qué orden, porque el bug no está localizado hasta que lo buscas.
La segunda pregunta es más interna y más difícil de responder con honestidad: ¿necesitas que el modelo decida, o solo necesitas que el modelo haga una tarea difícil? Mucha gente que quiere “un agente” en realidad quiere que el modelo resuelva un problema que no sabe resolver con una llamada. Son dos cosas distintas: la primera necesita un bucle, la segunda necesita un buen prompt y quizás un poco de retrieval.
Los cinco patrones de workflow, del más simple al más complejo
Anthropic propone empezar siempre por la solución más simple y solo aumentar la complejidad cuando haga falta, y en su guía define cinco patrones que cubren la enorme mayoría de los casos reales. Ninguno requiere un framework; todos se implementan en pocas líneas llamando a la API del modelo directamente.
1. Prompt chaining
La tarea se descompone en una secuencia de pasos, y la salida de cada paso es la entrada del siguiente. Lo interesante no es la descomposición sino las validaciones que se pueden intercalar: si el paso dos produce algo que no cumple un formato, el código puede cortar ahí y no gastar el paso tres. El patrón encaja cuando la tarea se puede descomponer limpiamente en subtareas fijas, y su pega es la latencia: cada paso es una llamada al modelo y el tiempo total es la suma.
2. Routing
Una primera llamada clasifica la entrada y dirige el caso a un camino especializado. El beneficio es de separación de responsabilidades: cada camino puede tener su propio prompt optimizado para su tipo de entrada. La advertencia importante de la guía es que optimizar un solo tipo de entrada sin routing puede perjudicar el rendimiento en los demás, porque el prompt se va inclinando hacia un caso y se aleja del resto. Con routing, cada tipo tiene su prompt.
3. Parallelización
Tiene dos variantes que conviene no confundir. La seccionamiento divide la tarea en subtareas independientes que corren en paralelo y se vuelven a unir al final. La votación corre la misma tarea varias veces con enfoques distintos y elige el resultado por consenso o por puntuación. La sección es la que más se usa; la votación reserva su lugar para tareas donde una sola ejecución tiende a fallar y tres ejecuciones distintas se combinan y se elige la salida que más se repite. El límite de las dos es el mismo: reunir las salidas requiere un criterio de combinación, y ese criterio hay que escribirlo.
4. Orchestrator-workers
Un LLM coordina y varios ejecutan subtareas en paralelo, con el coordinador decidiendo qué subtareas hacen falta. Es la diferencia con el patrón anterior: ahí las subtareas están predeterminadas; aquí las decide el modelo en runtime según lo que va discovering. Es el patrón que más se parece a un agente y el que más se parece a un workflow, y por eso conviene saber cuál de los dos te sirve: si las subtareas son siempre las mismas, es prompt chaining; si cambian según la entrada, ya estás construyendo un agente.
5. Evaluator-optimizer
Un componente genera, otro evalúa y devuelve feedback, y el primero itera con esa corrección. Funciona muy bien en tareas donde hay un criterio de calidad comprobable: un código que tiene que pasar los tests, un texto que tiene que cumplir una plantilla, una consulta que tiene que devolver una forma concreta. Y tiene un costo escondido: es el patrón que más multiplica las llamadas al modelo, porque por definición itera.
Qué es un agente entonces
La definición operativa de Anthropic es precisa y corta: los workflows son sistemas donde los LLM y las herramientas se orquestan por rutas de código predefinidas, y los agentes son sistemas donde el LLM dirige dinámicamente su propio proceso y el uso de herramientas. La diferencia no está en las herramientas, que pueden ser las mismas en los dos casos. Está en quién elige el siguiente paso.
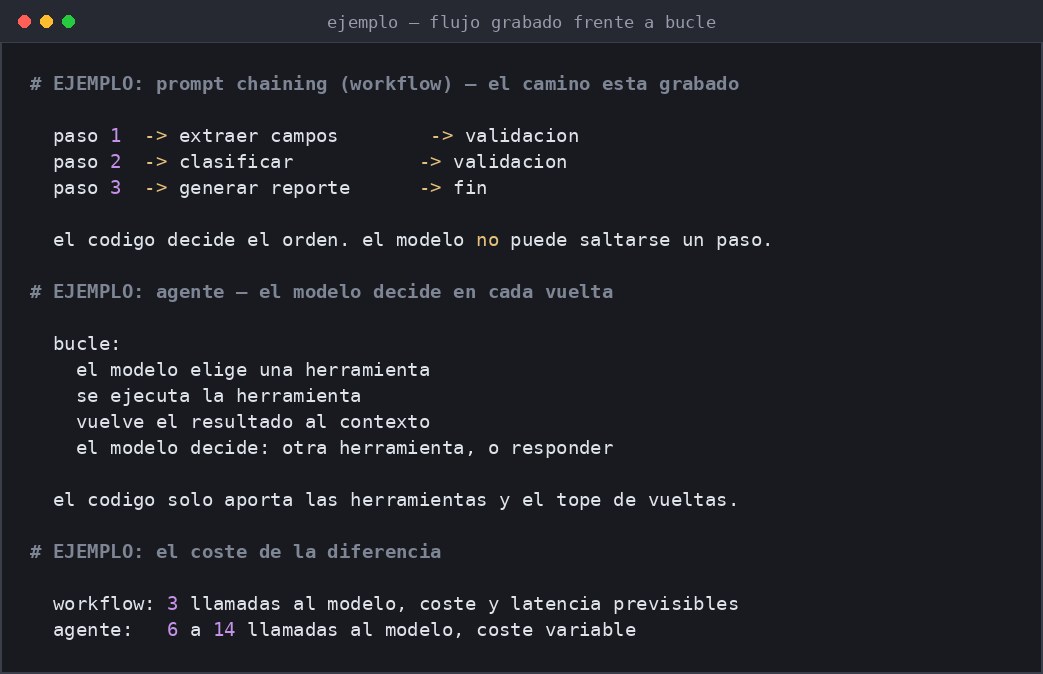
Y aquí está el detalle que casi nadie menciona: el agente no es más capaz por el hecho de ser agente. Es más caro y menos predecible por el hecho de ser agente. La guía lo dice en la primera página: los sistemas agénticos suelen cambiar latencia y costo por mejor desempeño en la tarea, y esa decisión hay que tomarla a conciencia. Si el mejor desempeño no compensa el costo ni la unpredictibilidad, el workflow gana.
La tabla para decidir
Uso esta tabla cuando alguien me pide “ponle un agente” y me cuesta argumentar por qué no siempre hace falta:
- El camino se puede enumerar. Workflow. No hay discusión.
- El camino depende de lo que se encuentre en runtime, pero el número de pasos es acotado y conocido. Orchestrator-workers con un tope de subtareas.
- El camino depende de lo que se encuentre y no sabes cuántos pasos hacen falta. Agente, con tope de iteraciones y presupuesto.
- La tarea es una transformación con criterio de calidad medible. Evaluator-optimizer.
- La tarea son subcasos claramente distinguibles. Routing.
- La tarea no necesita más que una llamada al modelo con buen contexto. Ninguno de los dos. Y esa es la respuesta que más veces sale.
Migrar de workflow a agente sin romper producción
Cuando el cambio está justificado, no se reemplaza el workflow de golpe: se agrega un paso agente dentro de un workflow que sigue siendo el shell. Es el patrón que menos riesgo da, porque todo lo que no depende del agente sigue funcionando igual.
El orden que uso cuando migro es este. Primero, el workflow con el camino grabado y sus validaciones, que ya es un sistema que funciona y que se puede probar con entradas fijas. Segundo, un paso del workflow reemplazado por una llamada al agente, con su descripción de herramienta y su tope de iteraciones, todavía con el resto del camino igual. Tercero, medir. La comparación que importa no es “el agente suena más inteligente”, es cuántas entradas cambian de resultado, con qué tasa de error y a qué costo. Si el número no mejora, el agente no aportó nada y solo añadió variabilidad.
# EJEMPLO: el shell sigue siendo determinista, un paso usa el agente.
# Si el agente falla, el shell tiene un camino de repliegue explicito.
def procesar(lineas):
    # paso determinista: filtrar lo que el agente no necesita ver
    candidatas = [l for l in lineas if "ERROR" in l]
    if not candidatas:
        return {"estado": "sin_incidencias", "detalle": []}
    # paso con agente: el camino exacto no se conoce de antemano
    informe = agente.ejecutar(
        tarea="explica la causa raiz de cada error y el fix",
        entrada=candidatas,
        max_iteraciones=6,          # tope duro de vueltas
    )
    if informe is None:
        # repliegue: el shell nunca queda sin respuesta
        return {"estado": "revisar_manual", "lineas": candidatas}
    return {"estado": "ok", "detalle": informe}
# EJEMPLO: routing determinista, sin llamada al modelo.
# La decision se toma con una regla explicita, no con una llamada.
tipo=$(echo "$linea" | grep -q "ERROR" && echo error || echo info)
case "$tipo" in
error) plantilla="Se detecto un error en el servicio" ;;
info) plantilla="Registro informativo del servicio" ;;
*) plantilla="Registro sin clasificar" ;;
esac
printf "%s: %s
" "$tipo" "$plantilla"El coste real de equivocarse de arquitectura
Hay un costo que casi nunca se cuantifica y que termina pesando más que el resto: el costo de debugging. Un workflow que falla te da un punto de fallo: el paso cuatro devolvió algo que no cumple el esquema, y ya sabes dónde mirar. Un agente que falla te da una conversación larga con decisiones dispersas, y reconstruir qué pasó exige leer el recorrido completo.
Ese costo se paga en cada incidente, y no baja con más modelos ni con mejores prompts. Por eso el orden sensato es el inverso al que se empieza: primero el shell determinista, después el agente en el punto que realmente lo necesita, y siempre con el tope puesto desde el primer día.
Preguntas frecuentes
¿Cómo sé si mi caso necesita un agente o un workflow?
Hazte la pregunta del resultado: si el paso anterior cambia, ¿el siguiente sigue siendo el mismo? Si la respuesta es sí, el camino está grabado y necesitas un workflow. Si es no, el modelo tiene que decidir y necesitas un agente. La trampa habitual es querer un agente para una tarea que en realidad necesita una buena llamada al modelo con contexto y recuperación, que es el caso más común de todos.
¿Un workflow no es un agente “menos inteligente”?
No son dos niveles de inteligencia: son dos arquitecturas de control. El workflow reparte el control en el código y el modelo aporta capacidad por paso. El agente deja el control en el modelo. Un workflow bien hecho con un buen modelo por paso puede superar a un agente mal acotado, porque el workflow aplica las validaciones que el agente se salta.
¿Cuánto cuesta de más un agente frente a un workflow?
Depende de las vueltas, pero como orden de magnitud un workflow de tres pasos hace tres llamadas al modelo y un agente equivalente hace entre seis y catorce, porque cada vuelta incluye razonamiento además de la llamada. La diferencia de costo se multiplica si el agente delega en subagentes, porque cada subagente arrastra su propio contexto. Por eso el tope de iteraciones y de subagentes es la primera configuración que hay que revisar.
¿Se puede usar un modelo pequeño en un workflow y grande en un agente?
Sí, y es una de las combinaciones más eficientes que existen. En un workflow cada paso es una tarea acotada, así que un modelo pequeño y barato por paso rinde bien. En un agente, el modelo central tiene que sostener el razonamiento de todo el recorrido, y ahí conviene el modelo fuerte, que puede delegar las subtareas mecánicas a modelos pequeños. Ese reparto es lo que sostiene el costo de un agente en producción.
¿Qué pasa si el agente falla y el shell no tiene repliegue?
El fallo se propaga y suele ser el peor de los escenarios: el sistema devuelve una respuesta incompleta con apariencia de respuesta válida. Por eso el repliegue tiene que ser explícito en el shell, no una excepción capturada que seloguea y se continúa. Si el agente falla, el sistema debe devolver un estado que obligue a una persona a mirar, nunca un resultado parcial disfrazado de completo.